


做 AI 漫剧最让人头疼的问题之一,不是生成不出图片,而是同一个角色到了下一镜,突然就像换了个人。
前一镜还是熟悉的脸,下一镜脸型变了;再往后,发型、服装甚至年龄感都对不上。单独看每张图,好像都不错,但把它们连起来,观众马上就能发现问题。
遇到这种情况,很多人会反复修改提示词,或者干脆换一个生成模型。但人物变脸不一定只是模型的问题,也可能是角色描述每次都在变化、参考图没有持续复用、分镜没有明确关联角色资产,或者提示词中混入了相互冲突的外观要求。
AI漫剧角色一致性的核心,是将人物外观转化为可复用的角色资产,并让角色信息在每个镜头中得到一致引用和检查。 具体可以从角色设定卡、参考图、Shot 镜头关联、提示词分层和逐镜检查这五个方面入手。
一、先定位问题:变脸通常发生在哪三个环节
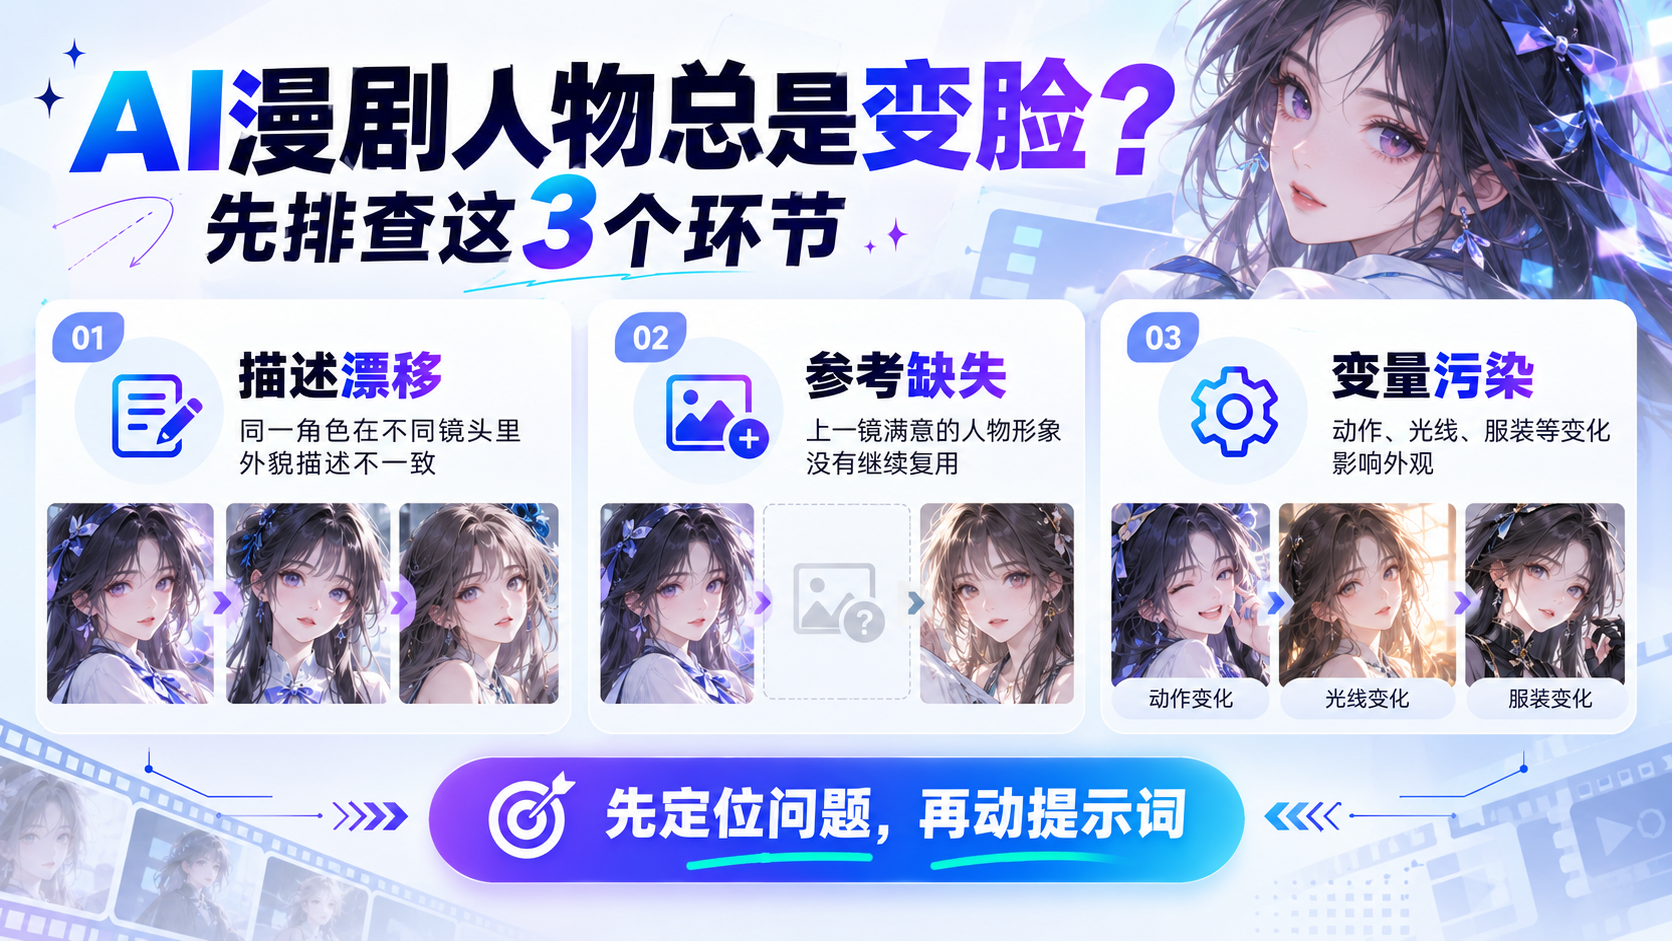
在反复修改提示词之前,先判断问题出在哪里,可以减少很多无效重试。常见原因主要有三类。
1. 描述漂移
同一个角色,第一镜写“黑长直、丹凤眼、冷白皮”,第三镜改成“长发、细长眼、皮肤白皙”。
人看起来觉得意思差不多,但模型每次接收到的描述并不完全相同,生成结果就可能出现差异。
2. 参考缺失
上一镜生成的人物形象很满意,但下一镜没有继续使用这张图片作为参考,模型只能根据当前提示词重新生成角色。
即使人物描述没有变化,也不代表每次都能得到完全相同的脸。
3. 变量污染
为了改变镜头动作,你顺手修改了人物描述;或者不同镜头中,服装、年龄、发型等信息不断变化。
这些本来应该保持稳定的外观信息,就可能受到其他要求的干扰。
解决思路并不复杂:固定角色描述、复用人物参考图,并将提示词中的固定信息与镜头变量分开管理。
下面这五个方法,就是将这些思路落实到制作流程中的具体做法。
二、方法1:把角色写成可复用的“设定锚点”
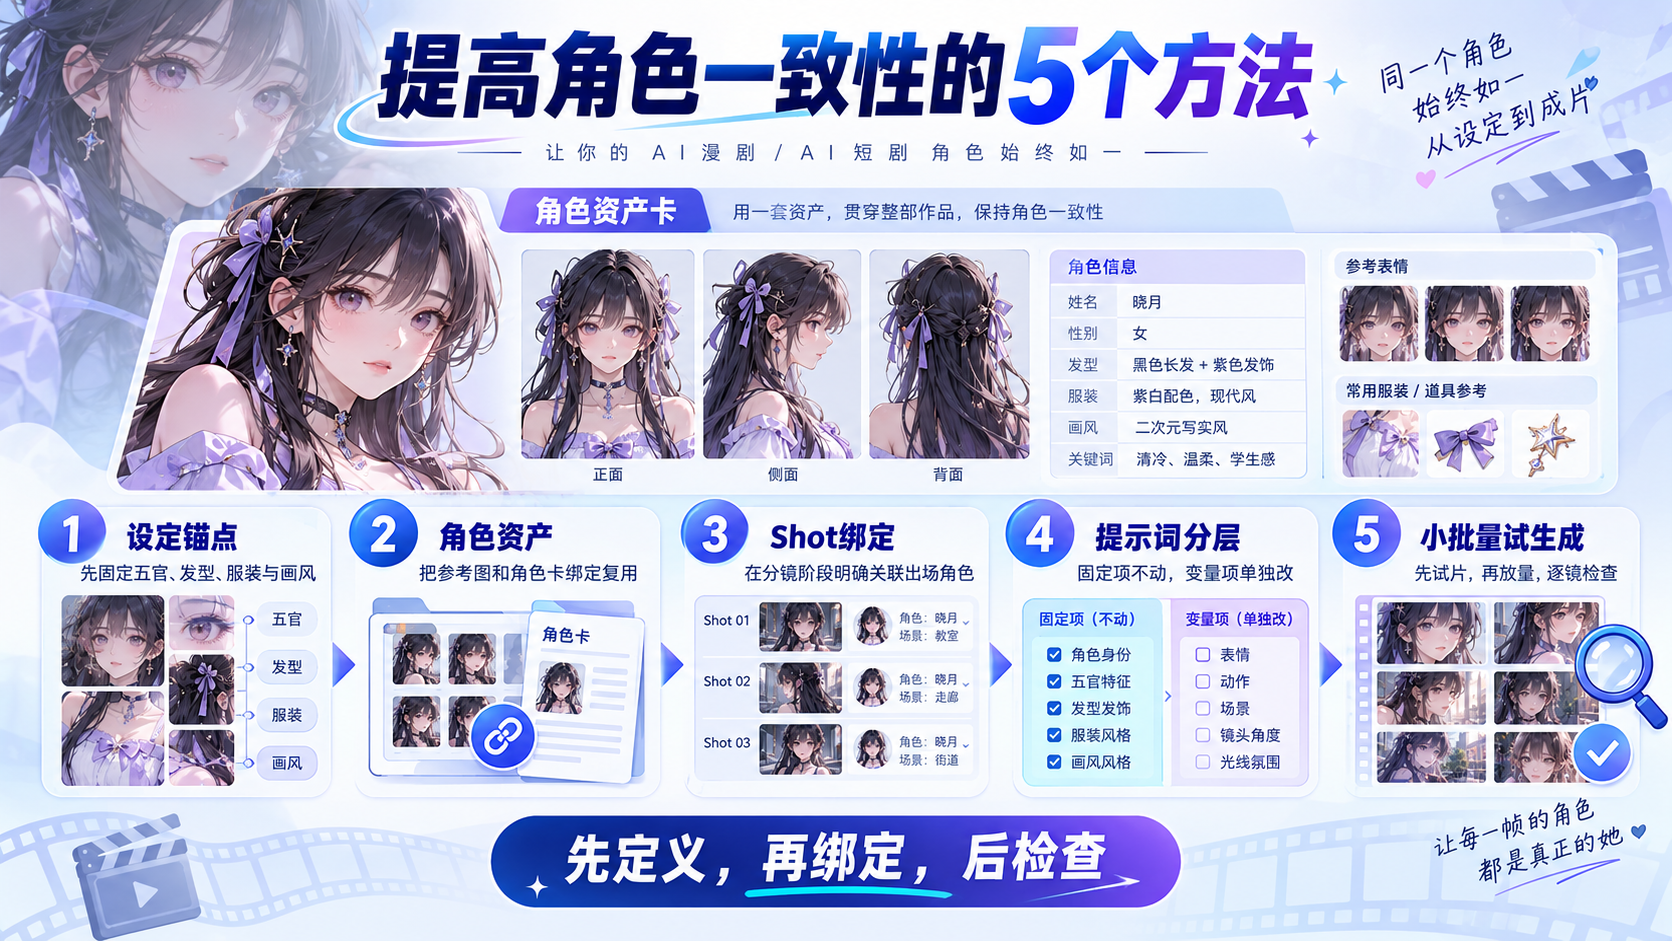
不要每次制作镜头时都重新描述角色。更稳妥的做法,是先建立一份统一的角色设定卡,后续镜头都以这份设定为依据。
一份实用的角色设定卡,建议包含五组信息:
- 骨相与五官: 脸型、眉眼形状、鼻梁、唇形,以及明显的辨识特征。
- 发型与发色: 头发长度、分缝、刘海、束发方式等。
- 服装与配饰: 主要颜色、款式、材质和标志性单品,例如发簪、耳坠或披风扣。
- 年龄与气质: 角色的年龄感、体态和常见表情特征。
- 画风锚点: 线条、上色方式、材质表现和光影风格,帮助角色保持统一的视觉风格。
关键是保持描述稳定。
例如,同一个角色已经确定为“丹凤眼”,后续就不要随意改成“上挑眼”;已经确定为齐肩发,也不要在没有剧情依据的情况下改成披肩长发。
设定卡中的文字可以直接复用,不必每次都重新组织语言。
这一步不需要复杂工具,但能够减少因人物描述变化而产生的不必要偏差。
实操建议: 先确定角色设定,再开始批量制作镜头。不要一边生成剧情,一边临时决定主角长什么样。
三、方法2:用角色资产卡和参考图固定人物形象
文字描述能够说明角色应该长什么样,但不一定能让每次生成的脸完全一致。
如果希望同一个角色在多个镜头中保持相对稳定,除了固定文字设定,还需要建立可以反复引用的视觉参考。
在 HEIMASHOW 的项目结构中,这一步对应角色资产管理。按照你提供的官方产品资料,平台通过角色资产卡片、角色描述与提示词、参考图,以及镜头对资产的引用来支持角色一致性管理。
实际制作时,可以按照以下顺序操作:
- 制作角色定妆图。 根据设定卡生成若干张候选图片,挑选五官、发型和服装都符合要求的一张作为基准。
- 建立角色资产。 将确定的参考图与角色设定关联,避免后续镜头反复使用不同的相似图片。
- 在后续镜头中复用。 生成新镜头时,尽可能引用同一个角色资产和基准参考图,而不是每次重新描述一个“差不多”的人物。
如果角色会频繁转身、侧身或出现在远景中,还可以提前准备正面、侧面、背面和全身参考图,让不同角度下的造型更容易核对。
这里必须说明一个边界:角色资产和参考图是帮助管理一致性的手段,并不意味着可以保证生成结果绝对不变脸。
最终画面仍然会受到提示词、构图、动作、光线和模型能力等因素影响。因此,资产准备完成后,仍然需要逐镜检查。
另外,如果修改了上游的角色设定,也不要默认所有已经生成的下游内容都会自动更新。
按照你提供的官方资料,脚本与资产信息可以向下游生成环节传递,但针对单个生成器进行的修改,默认不会反向写回上游脚本。
这意味着,修改角色设定后,需要主动判断哪些镜头受到影响,并检查是否需要重新生成。
四、方法3:在分镜阶段就把角色绑定到 Shot
有些人物一致性问题,其实在正式生成之前就已经埋下了。
例如,分镜中只写了一句“她推开门”,却没有明确这一镜对应哪个角色,也没有关联相应的角色资产。到了生成环节,就可能出现角色信息不明确的问题。
AI 漫剧通常以 Shot,也就是镜头为单位组织画面。一个 Shot 可以包含景别、角色、动作、场景和台词等信息。
按照你提供的 HEIMASHOW 官方资料,项目中的脚本节点可以将剧本拆解为结构化的 Shot,并关联角色、场景和道具资产,再据此形成用于生成的镜头提示词。
这套机制对创作者的实际价值,在于把“这一镜是谁出场”变成明确的结构化信息,而不只是依靠一句模糊的文字描述。
建议重点检查三个方面:
- 每个镜头明确出场角色。 尽量指向对应的角色资产,而不是只写“女主”“男二”或“她”。
- 场景和道具也保持关联。 同一间房间、同一件关键道具,尽可能使用统一的参考资产,减少不必要的视觉差异。
- 多人同框时逐一确认。 特别是对视、争执和群像镜头,需要核对每个角色是否关联了正确的资产。
举个例子。
如果剧本中的主角叫张青,那么分镜中不应只写“她走进房间”,而应明确这一镜的出场角色是张青,并关联张青对应的角色资产。
这样,后续生成时就有更明确的信息依据。
需要注意的是,结构化关联能够减少信息混乱,但并不能自动消除所有生成误差。最终画面仍然需要检查。
五、方法4:提示词分层,固定项不动、变量项单独改
如果每次修改镜头动作,都顺手重新描述一遍人物长相,就很容易出现“改一处,崩一片”的情况。
一个实用的办法,是把提示词拆成固定层和变量层。
固定层:整部作品中尽量保持不变的信息
包括:
- 角色设定卡原文;
- 角色的主要外观特征;
- 统一的画风描述;
- 对应的角色参考图。
这些信息应当集中管理,需要时直接复用,避免每个镜头重新改写。
变量层:根据当前镜头调整的信息
包括:
- 景别和构图;
- 人物动作与表情;
- 镜头角度和运镜;
- 当前场景的光线与氛围;
- 与剧情相关的环境变化。
变量层只描述这一镜具体发生什么,不必每次重新创造人物外观。
例如,角色已经确定为黑色齐肩发、深蓝色外套,那么这一镜可以写:
“人物低头看向桌面,随后缓慢伸出右手拿起信封。镜头从中景推进至近景,重点表现手部动作和视线变化。”
而不是每次都重新写一遍“漂亮的年轻女孩、精致五官、乌黑长发”等描述。
后者看似更详细,却可能给模型带来额外的外观变化信息。
还有两个细节值得注意:
- 避免互相冲突的外观要求。 例如同时要求披发和高马尾,或者要求人物正面看镜头又完全背对镜头。
- 重点镜头单独检查。 特写对面部特征要求较高。如果角色一致性特别重要,可以将关键特写镜头单独生成和筛选。
如果你使用的生成工具支持参考强度、随机种子等参数,也可以根据工具实际能力考虑固定相关设置。但具体功能、名称和取值范围,应以当前工具界面及官方说明为准,不要直接套用其他工具的参数。
六、方法5:小批量试生成,逐镜头检查后再放量
人物一致性不适合等到所有视频都生成完了才统一检查。那时如果发现大量镜头中的人物外观不一致,返工成本往往更高。
更稳妥的方式,是先小批量验证,再逐步扩大生成规模。
第一阶段:确定角色定妆图
先把角色基准图做好,重点检查五官、发型、服装和画风。
如果连基准图都没有达到预期,就不要急着进入后续制作。
第二阶段:挑选代表性镜头试片
可以先选取 3—5 个具有代表性的镜头,例如:
- 正面面部特写;
- 侧面镜头;
- 全身镜头;
- 带有明显动作的镜头;
- 与其他角色同框的镜头。
通过这些镜头,检查角色在不同角度、动作和构图下是否仍然保持相对一致。
第三阶段:试片通过后再批量生成
当角色设定和试片都基本符合要求后,再处理剩余镜头。
这里有一个容易被误解的地方:按照你提供的 HEIMASHOW 官方资料,批量生图并不是由一台生成器同时处理全部镜头,而是根据选定的 Shot 创建一组对应的生成器,每个任务分别对应相应镜头。
这种任务组织方式有利于针对单个镜头进行检查和返工。某个镜头不理想时,可以单独修改对应任务,而不必默认整批重做。
不过,批量生成本身并不等于批量通过验收。生成结果仍然需要按照角色设定逐镜检查。
七、一张可执行的角色一致性检查清单
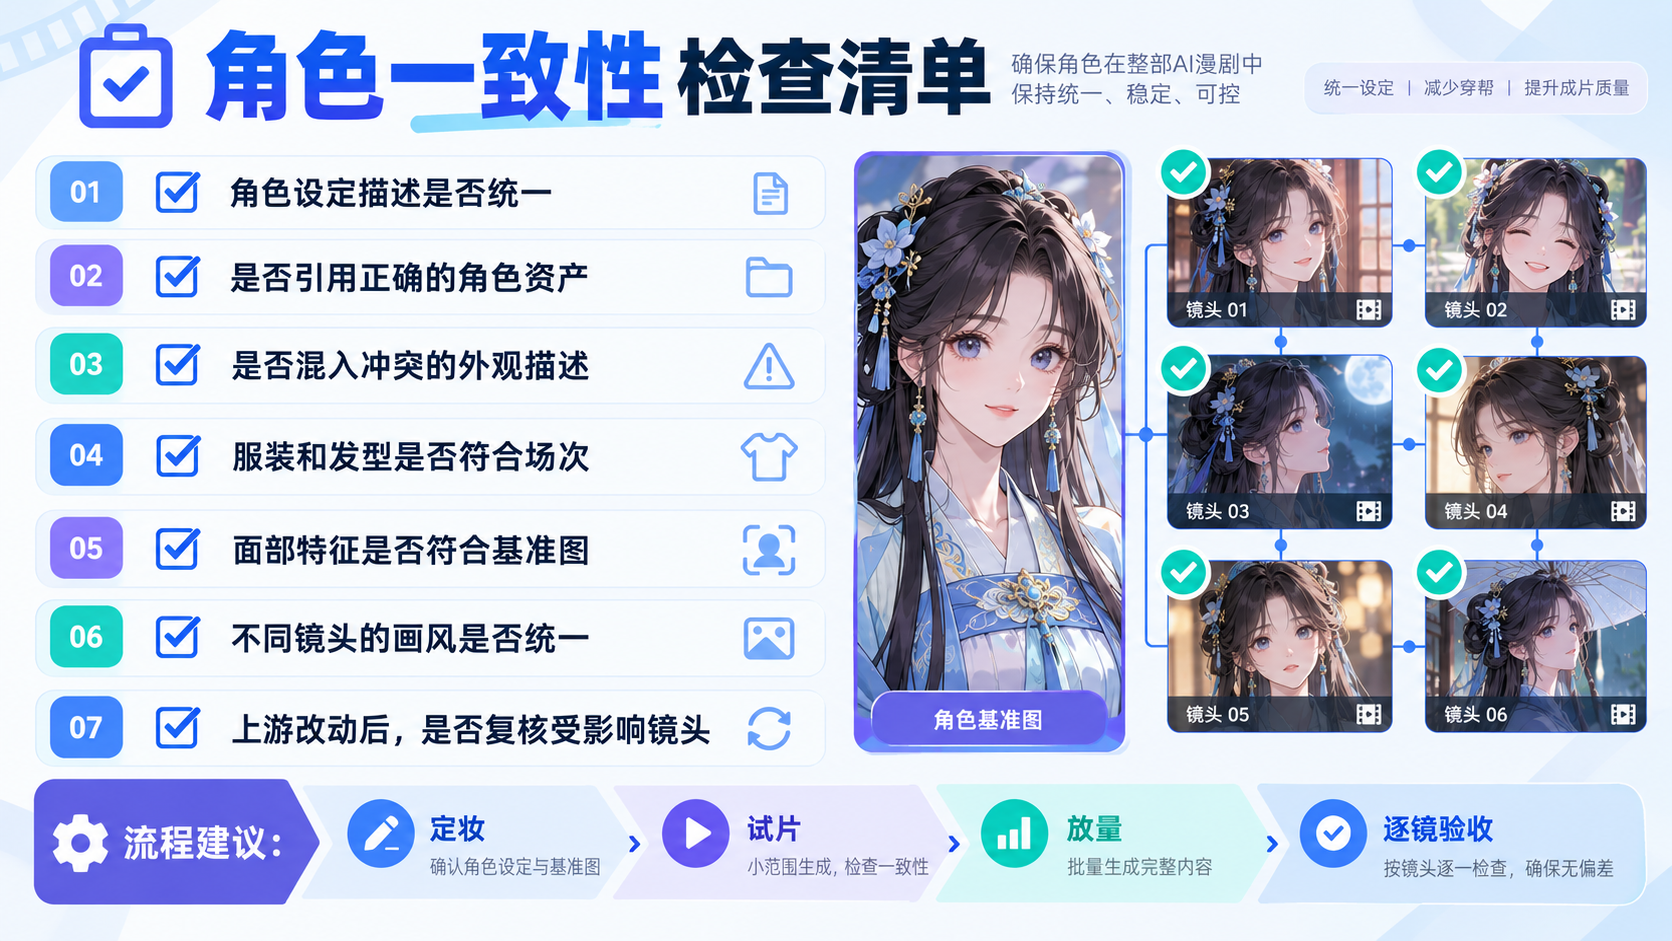
为了避免检查完全依赖个人感觉,可以将人物一致性拆成具体项目。
| 检查项 | 检查时机 | 不合格时的处理 |
|---|---|---|
| 角色设定描述是否统一 | 编写提示词时 | 回到设定卡,复用原始描述 |
| 是否引用正确的角色资产 | 分镜确认时 | 检查并修正资产关联 |
| 是否混入冲突的外观描述 | 生成前 | 删除冲突内容,区分固定项与变量项 |
| 服装和发型是否符合当前场次 | 生成前 | 以剧本和场次设定为准 |
| 面部特征是否符合基准图 | 图片生成后 | 单独修改或重新生成对应镜头 |
| 不同镜头的画风是否统一 | 每场结束后 | 检查画风描述和参考图 |
| 上游设定修改后,哪些镜头受影响 | 修改角色资产后 | 列出受影响镜头并逐一复核 |
这张清单的作用,是把“这个人物看起来不太对”转化为可以定位的问题。
例如,发现某个镜头的主角发型发生变化,就可以优先检查角色设定、参考图和提示词,而不是直接重新生成整个场景。
八、HEIMASHOW在这套流程中适合承担什么?
前面五个方法解决的是角色一致性的制作问题。但当项目从几个镜头扩大到几十个镜头,甚至包含多个角色和场景时,另一个问题也会变得明显:角色信息、分镜、参考图和生成任务,能否在同一个项目中被清楚地组织起来?
如果只是偶尔生成几张图片,使用独立生成工具配合文件夹管理就可以满足需求。
如果需要持续制作多镜头、多角色的 AI 短剧或 AI 漫剧,则可以考虑使用工作流平台管理项目内容。
HEIMASHOW:组织剧本、角色资产与镜头任务
HEIMASHOW官网 是面向 AI 视频、AI 短剧与 AI 漫剧创作需求的工作流平台,采用无限画布与节点式创作方式。
按照现有官方产品资料,平台可以通过文本、图片、视频、脚本和音频等节点组织创作内容。
其中,脚本节点可以将剧本拆解为结构化的 Shot 镜头,并关联角色、场景和道具资产,为后续提示词编写以及图片、视频生成提供对应的镜头信息。
对于需要连续制作多个镜头的创作者,这种方式有助于将剧本、参考资产和生成任务放在同一个项目中组织,减少在不同文件夹、文档和生成记录之间反复查找的操作。
例如,某个镜头的人物外观不符合预期时,可以先检查该镜头关联的角色资产与生成任务,再决定是否需要修改提示词或重新生成。
但需要明确:工作流管理并不意味着可以完全自动保证人物一致性,也不意味着所有镜头都能一次生成成功。参考图、提示词、模型能力和人工检查仍然是整个制作流程的重要组成部分。
如果你只是想生成一张图片或一段短视频,独立生成工具可能更直接;如果你准备持续制作多集内容,可以进一步了解工作流平台的角色资产管理、镜头组织和返工方式。
具体操作可以参考 HEIMASHOW官方创作学院。
本文涉及的 HEIMASHOW功能描述依据现有官方产品资料整理,包括《Heimashow-使用指南》(2026年9月1日版)。具体功能的可用范围和界面细节,以产品实际版本为准。文中关于提示词分层、小批量试生成等内容属于制作方法建议,不代表平台对生成结果的保证。
九、常见问题
Q1:用了参考图和角色资产卡,为什么还是会变脸?
参考图和角色资产可以提供统一依据,但生成结果还会受到提示词、景别、动作、光线和模型能力等因素影响。
建议先检查角色描述是否统一、参考图是否正确引用,以及当前镜头是否存在冲突要求。发现偏差后,优先单独修正对应镜头,而不是反复重做整段内容。
Q2:一部漫剧有上百个镜头,每个镜头都检查来得及吗?
可以采用分层检查。
定妆阶段和试片阶段严格检查;批量制作阶段按照统一清单检查,并重点关注面部特写、多人同框、转身和重要情绪变化等镜头。
这样可以把检查资源集中在更容易出现明显偏差的地方,同时降低整批返工的风险。
Q3:修改角色设定后,之前生成的镜头会自动更新吗?
不能直接这样假设。
按照现有 HEIMASHOW 官方资料,下游针对单个生成器的修改默认不反向写回上游脚本。因此,修改角色设定后,需要主动判断哪些镜头受到影响,并检查是否需要重新生成。
Q4:多人同框时,怎么减少角色混淆?
首先为每个角色准备独立的参考资产,并在分镜中明确标注出场角色及其对应关系。
提示词中也应明确每个人物的身份、位置和动作,避免只使用“两人”“他们”等模糊指代。
如果复杂同框镜头反复生成失败,可以根据具体制作条件考虑拆分镜头,分别处理单人画面,再通过后期完成衔接。
总结
AI 漫剧人物变脸,通常不能只靠反复修改一条提示词来解决。
更可靠的做法,是先固定角色设定,再通过参考图和角色资产复用形象,在 Shot 中明确关联出场角色,将提示词拆分为固定项和变量项,最后通过小批量试生成与逐镜检查及时发现偏差。
其中,前三个环节解决的是角色信息能否被稳定传递的问题,后两个环节解决的是生成偏差能否被及时发现和修正的问题。
工具可以帮助组织角色资产、分镜和生成任务,但不能代替最终的画面检查。
真正值得追求的,不是每个镜头都保证一次生成成功,而是当人物出现偏差时,能够迅速找到原因,并准确地修改对应镜头。
如果你正在从单张图片生成转向连续的 AI 漫剧制作,希望把角色资产、分镜和生成任务组织到同一个项目中,可以进一步了解HEIMASHOW官网,或访问 HEIMASHOW官方创作学院查看相关教程。